
Porque bancos relacionais sofrem com histórico de processo e o que muda quando você usa um historiador industrial como o Elipse Plant Manager (EPM)?
A cena
A reunião de produção começa e alguém abre o painel com a tendência do último mês. A tela fica girando. Alguém sugere “olhar só a última semana”. Na outra planta, o painel até abre, mas os nomes das tags são diferentes e ninguém consegue comparar as duas linhas.
Nas visitas recentes do nosso time comercial, esse cenário apareceu em vários clientes. A arquitetura era sempre parecida: diversos SCADAs (incluindo o Elipse E3) gravando dados de processo em um banco relacional comum e o Grafana surgindo por cima para visualização. A queixa que motivou a conversa era sempre a mesma: desempenho do banco.
Essa arquitetura é muito comum e faz sentido no começo. O SCADA já sabe gravar em banco, a TI já administra o banco e o Grafana é gratuito e bonito. O problema aparece com o tempo.
Sintoma e causa raiz
O sintoma é “o banco está lento”. A reação comum é aumentar o servidor, criar índices ou apagar dados antigos. Isso alivia por alguns meses, mas não resolve, porque a causa está no tipo de dado.
Dado de processo é uma série temporal: milhões de valores de milhares de tags gravados continuamente e consultados quase sempre por intervalo de tempo. Um banco relacional usado de forma genérica sofre, nesse cenário, por alguns motivos:
- Volume: cada amostra vira uma linha. Com centenas de tags gravando em poucos segundos, a tabela chega a bilhões de linhas e os índices crescem junto.
- Agregação na hora da consulta: para mostrar a média horária de um mês, o banco precisa ler todos os valores brutos daquele mês, a cada atualização do painel.
- Concorrência: vários SCADAs gravando simultaneamente competem com as consultas dos painéis, que no Grafana se repetem a cada atualização de tela.
- Falta de contexto: cada projeto de SCADA apresenta sua própria tabela e nomenclatura. O banco guarda “TT_101_PV”, mas não sabe que isso é a temperatura do mancal da bomba 3.
- Falhas de rede: caso o SCADA grave direto em um banco remoto e o link caia, o dado daquele período poderá simplesmente não existir.
Nenhum desses problemas é culpa do Grafana ou banco. É uma ferramenta de propósito geral que faz um trabalho com nome próprio: histórico de processo.
O que um historiador faz diferente
Um historiador de processo é um banco projetado para séries temporais industriais. Na prática, isso significa:
- Coleta próxima da fonte e com buffer: caso a comunicação com o servidor caia, os dados ficarão guardados localmente, sendo enviados quando a conexão retornar.
- Armazenamento compacto: os valores são gravados em blocos compactados e não em uma linha por amostra.
- Consultas por tempo e agregação nativas: médias, mínimos, máximos e interpolações são parte do motor, não uma query que alguém escreveu à mão.
- Modelo de ativos: os dados são organizados pela estrutura da planta (área, equipamento, medição, entre outros), não por nomes de tags soltos.
- Acesso padronizado: ferramentas de análise, planilhas e sistemas corporativos consomem os dados pelas mesmas interfaces.
Como o EPM resolve
O EPM é o historiador e plataforma de dados de processo da Elipse. Aplicado ao cenário acima, a arquitetura muda da seguinte forma:
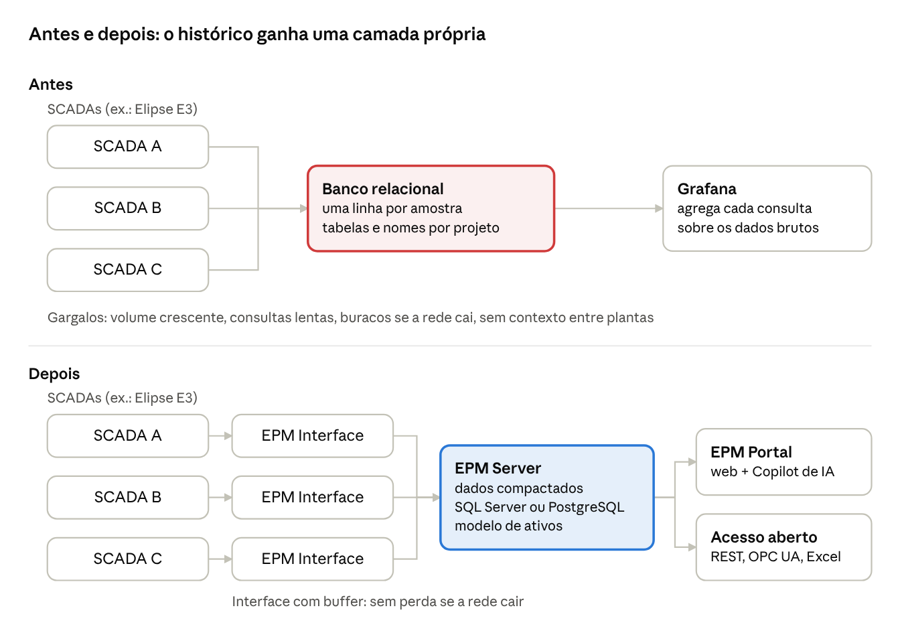
Arquitetura antes e depois · SCADAs gravando em banco versus EPM como camada de histórico
No cenário atual, cada SCADA grava direto no banco e o painel refaz as contas a cada atualização. Com o EPM, a coleta fica junto da fonte, com buffer, e o histórico passa a ter uma camada própria.
- EPM Interface fica próximo de cada SCADA e coleta os dados por conexão nativa com o Elipse E3, OPC UA, bancos de dados ou mais de 500 drivers Elipse. Caso a rede caia, o Interface manterá os dados em buffer, evitando assim que haja perdas. As interfaces também podem ser redundantes.
- EPM Server recebe os dados de todas as plantas e grava em blocos compactados. O armazenamento segue sendo realizado em SQL Server ou PostgreSQL, ou seja, a TI segue administrando um banco já conhecido, mas com um volume muito menor e sem tabelas crescendo linha a linha.
- Modelo de ativos: quem já usa os softwares Elipse E3, Elipse Power ou Elipse Water importa o modelo de ativos do próprio projeto. A bomba 3 é a bomba 3 em todas as plantas.
- EPM Processor calcula indicadores e regras de forma centralizada, em vez de cada painel refazer a conta.
- EPM Portal entrega a visualização web e a versão 7.5 traz um Copilot de IA para consultar os dados em linguagem natural.
- Acesso aberto: API REST, OPC UA e suplemento para Excel. As ferramentas que a equipe já usa continuam tendo acesso aos dados.
O resultado é uma arquitetura na qual o SCADA volta a fazer o que faz melhor (supervisão e controle) e o histórico passa a ser responsável por uma camada própria, que escala conforme o número de plantas.
Por onde começar
Não é preciso trocar tudo de uma vez. Um caminho comum é começar com uma planta ou conjunto de tags críticos, rodar o EPM em paralelo à arquitetura atual e comparar desempenho e esforço de manutenção antes de expandir.
Quer avaliar o seu cenário? Fale com a Elipse para obter um diagnóstico da sua arquitetura de dados. (Opção: apontar para o webinar da série ou oferta EPM Starter).
